昆仑芯与openEuler完成兼容性互认证,持续拓展国产<span style='color:red'>算力</span>生态协同
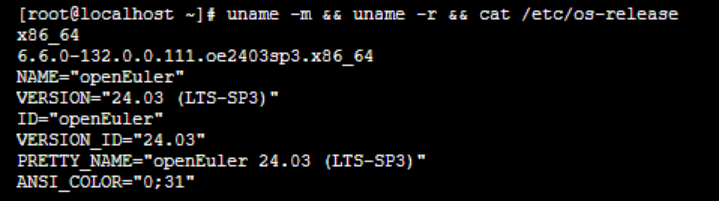
  近日,OpenAtom openEuler(简称 “openEuler” 或 “开源欧拉”)与昆仑芯P800系列产品完成兼容性互认证。双方围绕系统与设备识别、驱动及软件环境、链路与设备互联等关键环节开展验证,共七项子测试全部通过,验证了昆仑芯P800产品与openEuler在基础软硬件运行环境层面的兼容性,为国产算力产品在开源操作系统中的部署应用提供实践支撑。  此次认证是昆仑芯持续推进主流软硬件生态适配、深化生态协同的又一实践。通过与开源操作系统开展兼容性验证,进一步夯实算力产品与基础软件环境之间的协同基础,为后续开展AI框架适配、模型部署及业务验证创造条件。  深化软硬件适配,推动算力生态协同发展  随着AI算力应用不断拓展,算力产品的实际落地不仅依赖硬件能力,也需要操作系统、驱动、软件环境及设备互联等基础设施的协同支撑。软硬件兼容性是保障算力平台稳定部署和应用运行的重要基础。  本次兼容性互认证围绕系统识别、软件环境部署及链路互联等环节展开,重点验证openEuler对昆仑芯P800产品的识别能力、驱动与SDK部署情况,以及主机与设备、设备与设备之间的链路及互联能力。  测试结果显示,openEuler系统能够正确识别昆仑芯P800,驱动与SDK部署顺利,设备状态正常,设备互联相关测试均达到预期,七项子测试全部通过。  测试首先记录了操作系统基础信息,确认openEuler运行环境可用:  驱动安装完成后,系统可正确识别昆仑芯P800,并确认设备已绑定对应内核驱动、设备状态正常:  本轮验证覆盖基础运行环境中的多个关键环节,进一步打通国产AI加速卡与开源操作系统之间的软硬件协同通路,为算力产品融入多元化技术生态、拓展应用场景提供实践参考。  持续拓展主流生态适配,完善国产AI软硬件协同体系  人工智能产业的快速发展,正在推动算力生态从单一硬件能力竞争,向芯片、操作系统、AI框架、模型及应用等多层次协同演进。完善的软硬件生态适配能力,是降低用户部署门槛、提升算力应用效率、推动国产算力规模化落地的重要支撑。  围绕AI算力生态建设,昆仑芯持续推进与主流软硬件生态的适配与协作,现已构建覆盖基础软件、AI框架、模型及应用场景的完善的国产AI软硬件生态圈。在基础软件生态层面,昆仑芯积极推进与主流操作系统及相关软件环境的兼容验证,持续夯实算力产品的基础运行环境;在AI框架与模型生态层面,围绕主流框架及大模型开展适配、优化与部署验证,推动模型能力在昆仑芯算力平台上的应用;同时,通过与生态伙伴开展联合适配与技术协作,提升软硬件协同效率,促进适配成果向更多业务场景延伸。目前,昆仑芯已围绕多类主流软硬件生态开展适配与协同实践,持续拓展生态合作范围,推动算力能力与上层软件、模型及应用之间的衔接。  此次与openEuler完成兼容性互认证,是昆仑芯持续拓展主流软硬件生态适配范围的又一实践。通过基础运行环境验证,进一步夯实了昆仑芯算力产品与开源操作系统之间的协同基础,也为后续开展更深层次的软件适配与业务验证创造了条件。  未来,昆仑芯将持续加强与主流操作系统、AI框架、模型生态及产业伙伴的合作,推进软硬件适配成果积累与生态能力建设,逐步完善从底层运行环境到上层模型应用的协同体系,推动国产算力与开放软件生态深度融合,为用户提供更加开放、便捷、高效的算力应用环境,助力人工智能产业创新发展。
关键词:
发布时间:2026-10-21 09:52 阅读量:182 继续阅读>>
存力进阶,智造升级 | 佰维存储亮相2026中国国际工业博览会,释放工业AI澎湃<span style='color:red'>算力</span>
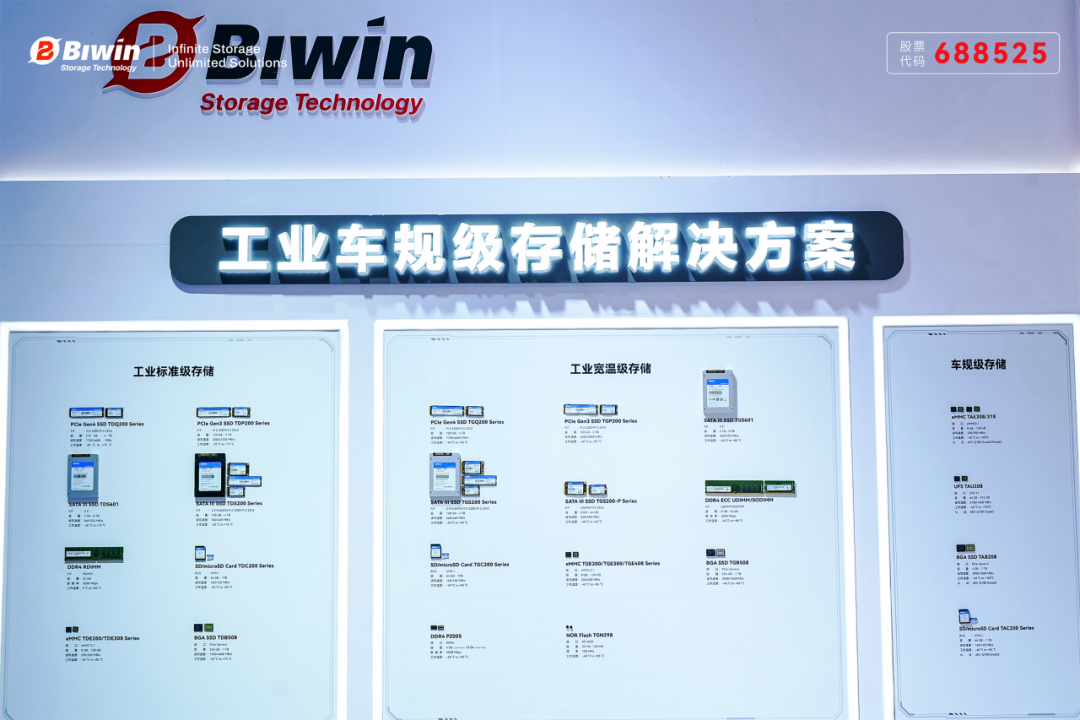
  10月12日-16日,第26届中国国际工业博览会(CIIF 2026)在上海盛大举行,佰维存储携工车规存储全系产品矩阵亮相大会。本次展会,佰维存储不仅现场展示了新品工业标准级eMMC TDE408-R,更通过前沿的技术分享与全栈场景方案展示,向业界展现了佰维赋能工业AI的硬核技术实力。  01  展台亮点:全栈存力进阶,六大场景智能升级  展会现场,佰维通过工车规全系产品矩阵与六大核心应用场景的立体化展示,全方位呈现佰维工车规存储解决方案。  佰维工车规产品面向工业自动化、智慧交通、电力能源、数据通信、智慧安防、汽车电子等领域,覆盖SSD、嵌入式存储、内存条、存储卡等多形态,提供工业标准级(-20℃至75°C)、工业宽温级(-40℃至85℃)及车规级(-40℃至105℃)多温度等级选择,构建高性能、高可靠AI存储底座,释放数据价值,提升AI算力效能。  从云端数据中心到边缘计算节点,再到智能终端设备,佰维工车规存储围绕AI“云-边-端”全域应用,精准聚焦六大行业场景,现场展示了深度定制的存储解决方案。  AI+工业:面向工业智能与边缘计算场景,佰维工业宽温级PCIe SSD、SATA SSD、BGA SSD、eMMC、DDR4等产品,以高性能、高稳定存储,加速数据处理与智能决策。  轨道交通:佰维工业宽温级/标准级SATA SSD、eMMC及SD/microSD Card,兼具强抗振、宽温设计、高速读写、低时延与秒级数据恢复能力,自主可控长稳供应,护航轨交长久运行。  智能汽车:佰维车规级eMMC、UFS、BGA SSD及车载SD/microSD Card,全系通过AEC-Q100、IATF 16949车规级认证,高带宽低延迟,驱动下一代智驾升级。  数据通信:佰维工业宽温级/标准级PCIe SSD,以高性能承载海量高频数据读写,高达8-10年生命周期的可靠性表现,构筑5G-A、边缘通信设备可靠数据底座。  电力能源:面向新型电力系统建设,佰维工业宽温级eMMC、DDR4以高可靠性满足电力国标要求,支持16年长稳运行,加速能源数据基础设施智能化升级。  智慧安防:针对大容量持续写入需求,佰维工业宽温级/标准级SATA SSD、eMMC及SD/microSD Card,最高实现32路视频不掉帧,数据稳留存,安全无盲点。  02  新品亮相:TDE408-R一芯双用,单颗承载系统+视频  本次展会,佰维新品工业标准级eMMC TDE408-R正式亮相。该产品创新采用一颗eMMC、两个使用分区的一体化存储架构,可根据客户对系统数据与视频监控数据的不同读写需求进行分区管理:系统分区可按实际需要配置,数据区则针对连续视频写入进行固件优化。该方案在满足客户使用需求的基础上,兼顾了经济性与产品寿命,并以单颗eMMC同时承载系统与录像数据,有效降低硬件集成复杂度。  TDE408-R支持eMMC 5.1与HS400高速模式,最高读写速度分别可达330MB/s、290MB/s,容量覆盖64GB-256GB,Enhanced Mode增强模式支持50,000次P/E Cycle,具备AOV功耗调优,可满足多路视频流不间断写入与极速响应需求,适用于执法记录、车载终端、智慧园区、轨道交通及社区安全等场景。产品搭载4K LDPC纠错引擎、电压异常监测及RPMB安全分区保护,集成坏块管理、磨损均衡、数据巡检等自研固件算法,保障长效稳定运行;支持S.M.A.R.T健康巡检与全项配置查询,可远程排查故障。此外,TDE408-R搭载自研主控与固件算法,实现从芯片设计、生产封测到成品交付的全链路自主可控。  03  演讲直击:破除存力瓶颈,释放工业AI算力  10月13日,佰维存储资深产品专家刘杰在第二届打造工业算力“芯”引擎技术研讨会现场带来了《破除存力瓶颈,释放工业AI澎湃算力》的主题演讲,直击AI时代工业存储的破局之道。  刘杰在演讲中指出,AI负载质变正在改变存算协同的数据行为,存储架构亟需从以容量为核心转向容量、时延、带宽、安全、可靠性等综合性能升级。对此,佰维依托研发封测一体化模式,持续完善从介质到产品的全栈技术布局,构建专业、持久、全面的系统级存储解决方案。  在介质层面,佰维通过介质特性研究与筛选,针对不同应用场景实现精准选型与适配;在主控层面,佰维已构建覆盖eMMC、UFS等品类的主控自研能力,首款自研eMMC主控SP1800已实现规模量产,首款自研UFS 3.1主控SP9300已完成投片与回片验证,同时围绕高性能架构与低功耗技术打造主控核心技术平台,不断强化性能与可靠性;在封测层面,佰维掌握16/32层叠Die、30~40μm超薄Die及多芯片异构集成等先进封装工艺,构建了2.5D/3D等晶圆级先进封装能力,并围绕AI硬件基础设施打造“存、算、运”综合服务平台,开发多种存算合封技术方案,保障高集成度与高可靠。  在此基础上,佰维“Win+”技术体系围绕稳定防护、环境加固、智能算法和数据保障,为工业AI应用提供稳定可靠的存力支撑。通过智能电源防护与梯度温控,提升异常断电和高低温环境下的运行稳定性;借助抗蚀、抗电磁干扰等设计,增强对严苛工业环境的适应能力;依托自研磨损均衡、垃圾回收、LDPC纠错等算法,延长存储寿命、优化实时效能;建立端到端数据保护机制,确保写入稳定与数据完整。  04  结语  本届工博会,佰维存储以工业车规级存储的全栈技术实力与六大场景解决方案,全面展现了赋能工业AI的硬核实力,为工业智造筑牢存力底座。  未来,佰维存储将持续依托 “研发封测一体化” 优势,不断完善工车规存储产品矩阵与场景化解决方案。同时不断强化供应链韧性与生态协同能力,以硬核技术、优质产品与专业服务,赋能工业、通信、汽车等领域数字化智能化转型,持续推动工车规存储向更高性能、更可靠、更智能的方向演进,为工业AI的澎湃算力注入不竭动能。
关键词:
发布时间:2026-10-19 14:14 阅读量:225 继续阅读>>
维安大电流SMD保险丝:为高<span style='color:red'>算力</span>平台保驾护航
  人工智能(AI)正在改变数据处理和分析的方式,并加速多个行业中的应用落地。因此,对高性能计算(HPC)基础设施(如AI服务器和数据中心)的需求正呈指数级增长。  AI服务器和数据中心依赖复杂的大功率系统来应对AI/机器学习(ML)工作负载所带来的巨大计算需求。这些系统包含高性能GPU、CPU和加速器,它们需要可靠的电力分配,以确保最大化的正常运行时间和效率。  用硬核设计回应大电流焦虑  维安大电流贴片保险丝设计上采用高强度陶瓷外壳,高纯度一体化合金熔丝配合优化结构,在 GPU 长时间满载烘烤和频繁冷热冲击下,依然保持稳定的熔断 I²t 特性,显著降低早期失效风险。  这种设计将冷态电阻控制在毫欧级水平,大电流通过时的压降和自身发热被有效抑制。既减轻了系统散热的额外负担,也避免了局部热点带来的可靠性隐患。  保护器件的分寸感最为难得  正常工作的浪涌它扛得住,灾难性短路来了它能迅速切断,在“误报”与“漏报”之间守住那道精准的保护窗口。  并且标准化贴片封装,轻松适配无铅回流焊接,全制程满足 RoHS 环保标准。工程师可将其就近部署在负载端,尽可能缩短大电流路径,提升供电网络品质。  核心参数一览  Surface mount high current fuse  表面贴装大电流保险丝  20A to 200A Rated current range  额定电流范围:20A至200A  Higher voltage rating up to 125 VDC  额定电压最高达125VDC  Higher breaking current up to 15 kA  分断电流最高达15kA  -55°C to 150°C Operating temperature  工作温度范围:-55°C至150°C  Excellent environmental integrity  优异的环境可靠性  Enhanced thermal cycling endurance  优越的热循环耐久性  RoHS compliant  符合RoHS标准  Halogen Free and Pb Free  无卤素,无铅  应用场景  每一颗大电流贴片保险丝背后,是维安WAYON三十年技术沉淀与严苛可靠性验证的合力——不追求高调,只求在高功率的严苛世界里,给你稳稳的安全感。
关键词:
发布时间:2026-09-21 10:24 阅读量:313 继续阅读>>
聚光<span style='color:red'>算力</span>!思瑞浦全系列光通信模拟芯片方案亮相2026CIOE
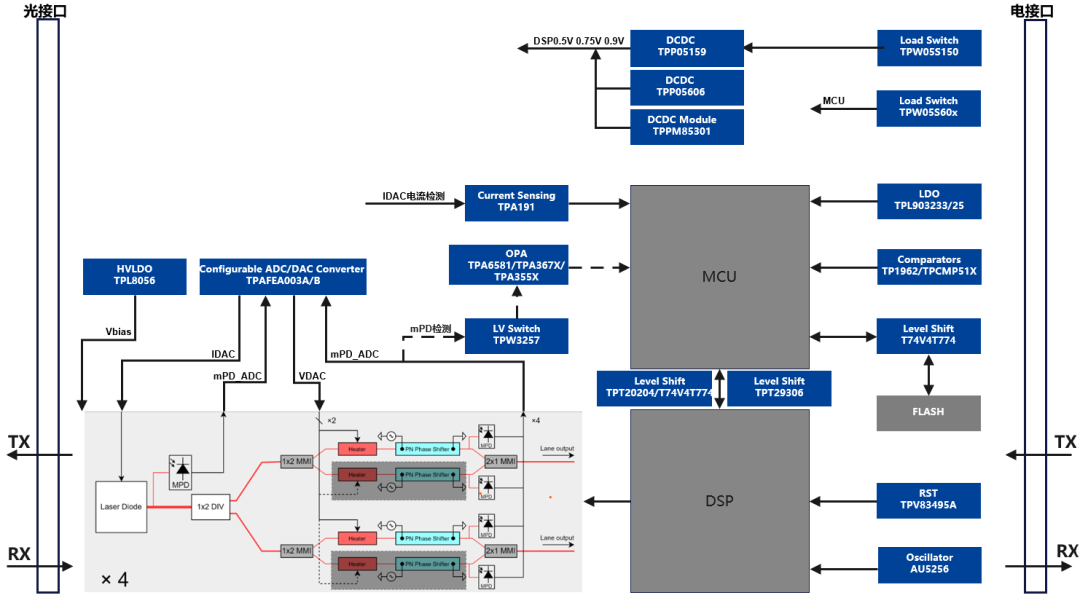
  2026年9月9日-11日,聚焦高性能模拟与数模混合产品的供应商思瑞浦(股票代码:688536)精彩亮相 2026 CIOE 光博会,集中展示面向光通信领域的模拟与数模混合芯片创新解决方案。展品覆盖800G/1.6T可插拔高速光模块方案(适配硅光、EML双技术路线)、CPO/NPO共封装光学与ELSFP外置光源量产级配套方案、OCS全光交换成套控制方案,以及相干光模块与EDFA光放大全链路方案,全面释放光通信模拟芯片的更多可能,助力客户探索AI算力与光互联时代的下一代创新。  思瑞浦CEO吴建刚表示:"AI算力需求的爆发式增长正在驱动光通信产业加速迭代,从800G到1.6T乃至更高速率的光模块演进,对模拟芯片的集成度、功耗与性能提出了前所未有的挑战。思瑞浦深耕高性能模拟与数模混合芯片领域,已围绕光模块、CPO、服务器等应用方向形成多层次、全品类产品布局。我们致力于以更高集成、更低功耗、更可靠的芯片方案,帮助客户应对高速光互联设计中的复杂挑战,携手推动光通信产业迈向新高度。"  800G/1.6T 可插拔高速光模块方案  覆盖硅光、EML 双路线,思瑞浦可提供一站式模拟芯片配套方案,满足AI算力中心高速光模块需求。  硅光路线上,TPAFEA003A/TPAFEA003B、TPAFEA005高精度硅光AFE专为 800G/1.6T 硅光模块定制开发,单颗芯片即可替代两颗及以上传统 AFE 器件,内部集成多通道 DAC、Heater驱动、多路IO与ADC,兼顾大电流激光器驱动能力与整机低功耗表现,可兼容各类主流PIC光子芯片,形成完整器件矩阵,实现光功率监测、温控以及信号采集全链路功能。  EML 路线依托TPAFEA108、TPAFEA008内置负压偏置电路,有效降低激光器调试门槛,适配集群短距离高速互联场景。其中TPAFEA108属于信号链与电源高度集成产品,大幅缩减外围元器件数量,降低整机成本与布板难度。后续迭代产品还将进一步提升通道密度、优化噪声指标,匹配1.6T EML光模块开发需求。整套方案依托低噪声电源器件保障模块实现高带宽、高消光比稳定输出,除光收发器外,同样可应用于测试测量仪器等设备。  CPO/NPO 共封装光学+ELSFP外置光源方案  针对下一代高密度光电集成技术发展方向,思瑞浦CPO/NPO共封装光学、ELSFP外置光源两套完整方案均已完成客户验证,有效帮助客户压缩产品研发周期,加快产品推向市场。  在CPO/NPO光引擎方向,思瑞浦打造多通道高精度AFE、低噪声LDO、高速接口、温度监测全维度芯片矩阵。结合共封装架构狭小的内部空间特点,产品重点完成小型化、低噪声专项优化,可完成激光器偏置调节、调制器偏压控制、光功率实时反馈等核心功能,支撑客户开发紧凑型、高可靠性光引擎产品。  ELSFP外置光源方案以TPAFEA003A/B多通道IDAC激光驱动为核心,搭配双通道低纹波Buck芯片TPP205307 ,具备输出纹波低、瞬态响应速度快的特性,能够抑制电源噪声对激光器造成干扰;双路独立输出可简化整机电源架构,保障输出连续波激光的稳定性。后续还将推出TPAFEA009集成分立IP方案,进一步优化PCB布板条件,压缩整机成本。整套方案支持热插拔与冗余设计,充分保障 AI 集群、数据中外置光源长期稳定工作。  OCS全光交换成套控制方案  面向数据中心全光交换(OCS)场景,思瑞浦展出OCS全光交换成套控制方案。方案涵盖光开关阵列的多通道高精度驱动、通道状态监测与系统控制逻辑,依托思瑞浦在多通道模拟前端、高精度数据转换器、接口与逻辑器件等领域的产品组合,为客户提供从驱动控制到状态监测的一站式芯片解决方案。  方案中的多通道高精度驱动芯片TPC2400 ,专为光开关阵列设计,具备多路独立通道、高精度电流输出,支持通道快速切换,同时集成状态检测功能,可实时反馈开关工作状态,降低外围电路复杂度。  思瑞浦在OCS领域已形成成熟的产品组合和客户量产经验,展台现场重点展示光开关阵列的高精度多通道驱动与控制技术,助力数据中心构建更高效、更灵活的全光交换网络。  相干光模块与EDFA光放大全链路方案  相干光模块方面,依托多路数模转换芯片TPAFEA003A/B、TPC2190,搭配精密运放TPA597x/599x、对数放大器TPA8304,充分满足相干系统对于高线性度、低相位噪声、低功耗的严苛技术指标。EDFA掺铒光纤放大器场景中,借助对数放大器完成泵浦光功率的精准检测,实现光纤链路信号无损放大。目前方案内多款信号链、电源类芯片已实现规模化批量出货,持续保障长途传输链路的信号传输质量。  思瑞浦是国内高性能模拟与数模混合芯片头部企业,业务覆盖泛通信、泛工业、汽车与消费电子四大下游。公司累计量产产品型号超3200款,在信号链、电源管理等30多个核心产品领域实现突破。随着光模块产品从800G逐步升级并布局更高规格1.6T产品,思瑞浦已形成多层次、高壁垒产品布局。未来,思瑞浦将持续聚焦高速光互联技术迭代,持续扩展高价值产品线,不断强化光通信模拟芯片核心竞争力,助力国内光通信产业自主创新与升级发展。
关键词:
发布时间:2026-09-10 10:06 阅读量:361 继续阅读>>
兆易创新三大产品线亮相2026光博会,共筑<span style='color:red'>算力</span>光联基座
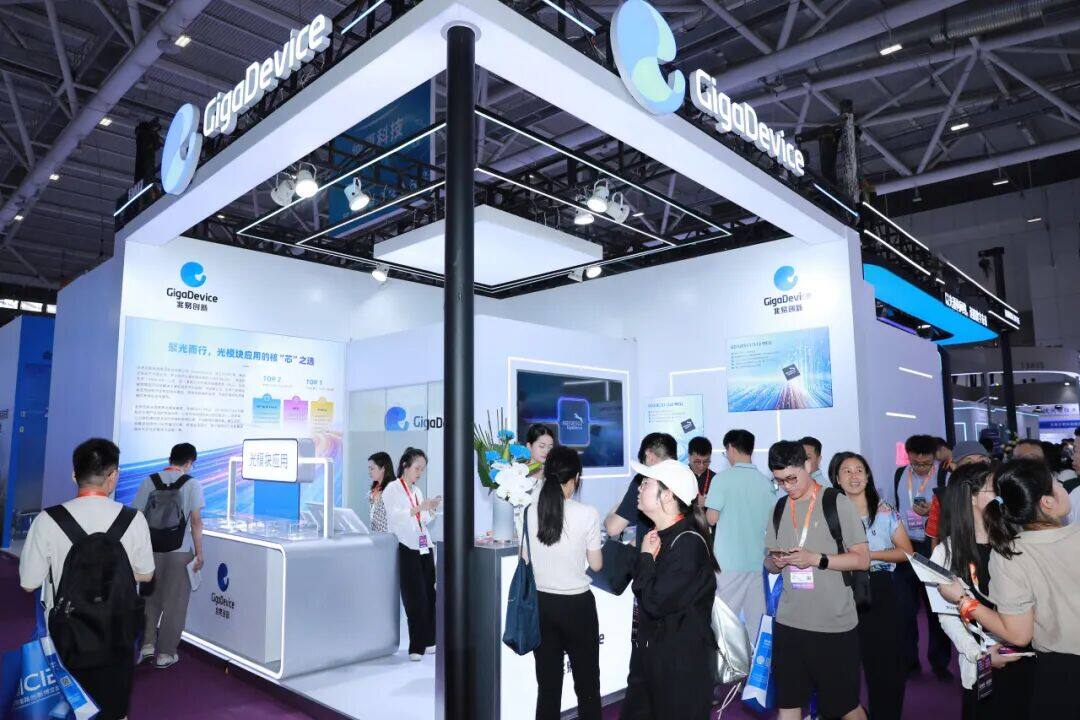
  9月9日,兆易创新(GigaDevice)携MCU、Flash、模拟三大产品线的光模块解决方案出席9月9日至11日在深圳国际会展中心举办的第27届中国国际光电博览会(CIOE 2026,展位号:13号馆13A17)。其中,今年发布的GD32E511/512、GD32E251/252系列光模块专用MCU将在本次展会上集中展示;截至目前,兆易创新光模块专用MCU累计出货量已近亿颗,稳居光模块MCU核心供应商之列。  AI大模型训练与推理集群的规模化部署,正在将数据中心光互联推向新的量级。从800G规模商用到1.6T加速落地,光模块作为算力网络的核心连接节点,其速率迭代与技术演进节奏明显加快,对系统DFM、存储与电源管理芯片在高性能、可靠性、小封装等方面提出了更高要求。兆易创新依托MCU、Flash、模拟三大产品线协同优势,为光模块客户提供多元芯片解决方案。  GD32光模块专用MCU  近亿颗出货构筑核心市场优势  兆易创新自2020年推出首颗光模块专用MCU以来,持续深耕光通信赛道,产品全面覆盖海内外主流光模块与设备客户。本次展会重点展示GD32E512/E511与GD32E252/E251系列MCU及相关光模块应用。其中,GD32E511/512系列MCU搭载Arm® Cortex®-M33高性能内核,支持小封装、大容量双Bank Flash、I3C通信协议等关键规格,适用于400G~1.6T高速场景;GD32E251/252系列MCU 则搭载Arm® Cortex®-M23内核,集成多路DAC、高精度温度传感器等,适用于接入网、前传等低速场景。  采用GD32E511 MCU的800G QSFP-DD光模块  传输距离可达2km至40km,支持 FlexO灵活光传送网多模式封装,符合CMIS Rev4.0、IEEE 802.3bs高速电接口及QSFP-DD MSA标准,具备数字光学监测能力,提供强大的诊断功能。  采用GD32E511 MCU的50G PON ONU光模块  符合ITU-T及IEEE 802.3标准,采用QSFP封装,支持上行50G/下行25G速率,具备数字光学监测能力。  采用GD32E252 MCU的XGS-PON & GPON Combo光模块  采用可热插拔SFP规格,支持上行9.95/2.48/1.24Gbps和下行9.95/2.48Gbps比特率,功耗小于3.5W,单模光纤最大链路长度20公里,符合ITU-T G.9807.1和ITU-T G.984.2标准。  GD25系列高可靠SPI NOR Flash  护航光模块固件存储  在光模块应用中,SPI NOR Flash承担存储固件与关键数据的功能,为DSP固件等高可靠数据提供存储空间。兆易创新GD25/55 SPI NOR Flash凭借全容量覆盖、高性能、高可靠性及超小封装等优势,已成为光通信设备的理想存储解决方案,目前已在国内外头部客户大批量出货。  本次展会重点展示GD25WD/WQ系列SPI NOR Flash产品,覆盖4Mb至16Mb容量,采用1.65~3.6V宽电压设计,支持工业级-40℃至+105℃宽温运行,具备WP写保护、OTP保护等功能,采用USON8 3mm×2mm超小封装,可充分满足光模块对高温运行和空间受限的设计需求。  此外,兆易创新还可提供GD24CL系列I²C EEPROM、GD25/55系列中大容量SPI NOR Flash、GD5F SPI NAND Flash和GD9F Parallel NAND Flash的产品阵列,为光放大器以及NPO/XPO等新兴光通信应用的技术演进提供更丰富的存储产品支持。  GD30系列高效电源管理  驱动光模块能效升级  随着光模块速率不断提升,功耗与热管理压力持续增大,高效、紧凑的电源管理方案成为光模块设计的关键环节。兆易创新模拟产品线重点展示了多款电源方案板:  GD30DM1113/GD30DM1116B高速光模块DSP降压电源模块  分别支持3A/6A连续工作电流,适用于400G及以上高速光模块,具备优越的动态响应能力、超低输出电压纹波和高效率,集成电感的超小封装有效节省PCB面积,并提供多种小封装选项。  GD30LS4171带电流监控功能的负载开关  支持7A连续工作电流,适用于400-800G高速光模块,实时输出电流监测精度高达±3%,具备200ns快速短路保护,输出电压上升速率与过流保护门限可调,采用QFN-2mm×2mm封装。  全栈协同,芯启高速光联未来  不同于单一芯片供应商,兆易创新在光模块领域的独特优势在于MCU、Flash、模拟三大产品线的协同能力,客户可同时完成控制、存储、电源管理等核心芯片的选型与适配,有效缩短研发周期、降低供应链管理成本,与此同时,兆易创新全流程的质量管理体系也可为光模块客户带来长期稳定的高品质产品体验。  未来,兆易创新将持续深化在光通信细分赛道的布局,以硬核技术驱动产品创新升级,依托全场景的产品生态与稳健的供应链保障,加速打通高速互联关键链路,为AI算力中心及下一代网络基础设施的高速光互联产业升级筑牢算力根基,注入澎湃发展动能。
关键词:
发布时间:2026-09-09 11:15 阅读量:390 继续阅读>>
GLM-5.3-Flash开源即适配,昆仑芯加速国产<span style='color:red'>算力</span>与大模型生态协同
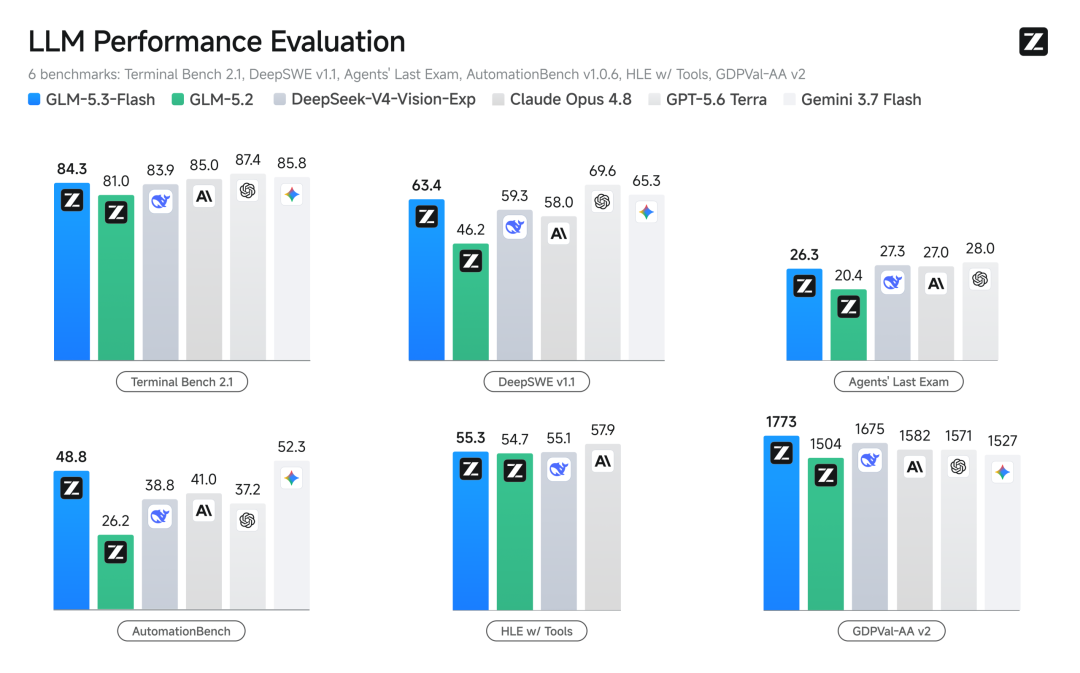
  8月26日,智谱正式发布并开源GLM系列的首个原生多模态模型GLM-5.3-Flash (320B-A18B)。模型开源当日,昆仑芯即完成对GLM-5.3-Flash的适配与联合精调,成为首批完成该模型适配的国产算力厂商之一,展现了面向前沿大模型的快速响应能力与生态兼容实力。近半年来,随着智谱持续推进GLM系列模型迭代,昆仑芯已完成对GLM系列多款模型的快速适配。此次快速适配不仅体现了昆仑芯面向前沿模型的Day 0响应能力,也进一步验证了国产算力支撑新一代大模型高效推理的能力。通过持续提升模型适配效率与优化软硬件协同能力,昆仑芯正加速推动前沿模型与国产算力生态协同,为大模型应用落地提供更加高效、敏捷的算力支持。  低成本高效推理,解锁大模型多场景应用  据介绍,GLM-5.3-Flash是GLM-5系列首个原生多模态模型。模型采用低成本架构,以320B总参数、18B激活参数实现高效推理,在保持模型能力的同时降低计算与服务成本。通过线性注意力与稀疏注意力相结合的混合架构,以及IndexPool等技术,模型进一步降低长上下文场景下的计算、显存和时延开销,支持最高1M上下文。  同时,GLM-5.3-Flash将视觉能力融入Coding流程,能够结合界面、渲染结果和交互反馈持续优化代码,覆盖前端开发、游戏构建、Blender 3D场景以及BUA、CUA驱动的真实环境操作等场景。此外,模型进一步拓展至Office、金融研究、专业文档等复杂任务,支持从分析研究到专业成果交付的完整工作流。  开源即适配,昆仑芯持续提升模型部署效率  随着国产大模型迭代速度不断加快,模型创新周期持续缩短,算力平台能否快速完成适配,正成为影响先进模型落地效率的重要因素。围绕智谱GLM系列模型演进,昆仑芯始终保持同步跟进,已完成GLM-4.7、GLM-5、GLM-5.1、GLM-5.2等多款模型的Day 0适配,不断提升模型从开源发布到国产算力部署及产业应用的响应效率。此次GLM-5.3-Flash开源后,昆仑芯第一时间完成模型适配与联合精调,实现对智谱最新模型的快速支持。这一快速适配能力,源于昆仑芯自研架构与长期深耕的软件栈。昆仑芯现已构建了覆盖底层驱动、开发工具SDK、专业算子库等核心环节的自研软件栈,持续提升算子覆盖广度与生态兼容深度,为模型快速迁移、高效部署与稳定运行提供坚实保障。依托完善的软件生态,昆仑芯进一步降低模型迁移与部署门槛,帮助开发者以更低成本、更高效率完成模型部署,加速AI应用创新。在本次GLM-5.3-Flash适配中,昆仑芯实现了模型精度无损迁移与高效部署,在保障稳定运行的同时充分释放硬件计算性能,降低模型部署门槛,缩短从开源发布到产业应用的落地周期。依托高效算力平台与自研软件栈优化能力,昆仑芯为GLM-5.3-Flash提供稳定、高效的国产算力支持,助力企业快速将前沿模型能力转化为实际业务价值。  “发布即适配”加速,模型与算力生态协同提速  在模型能力持续突破、创新周期不断缩短的背景下,模型厂商、算力平台、开发者与产业伙伴之间的协同效率,正成为推动AI技术规模化应用的重要因素。面对智谱GLM系列模型的持续升级,昆仑芯始终保持同步跟进,以更快的响应速度衔接模型创新与算力部署,推动主流模型更快进入实际应用场景。  面向未来,昆仑芯将继续深化与模型厂商、开发者及产业伙伴的合作,持续提升主流模型适配与部署能力,推动国产算力与模型生态高效协同,共同加速“国芯+国模”生态成熟,助力国产AI产业高质量发展。
关键词:
发布时间:2026-08-28 16:02 阅读量:474 继续阅读>>
相约2026算博会|永铭电解电容展区前瞻:主板<span style='color:red'>算力</span>场景电容方案全解析
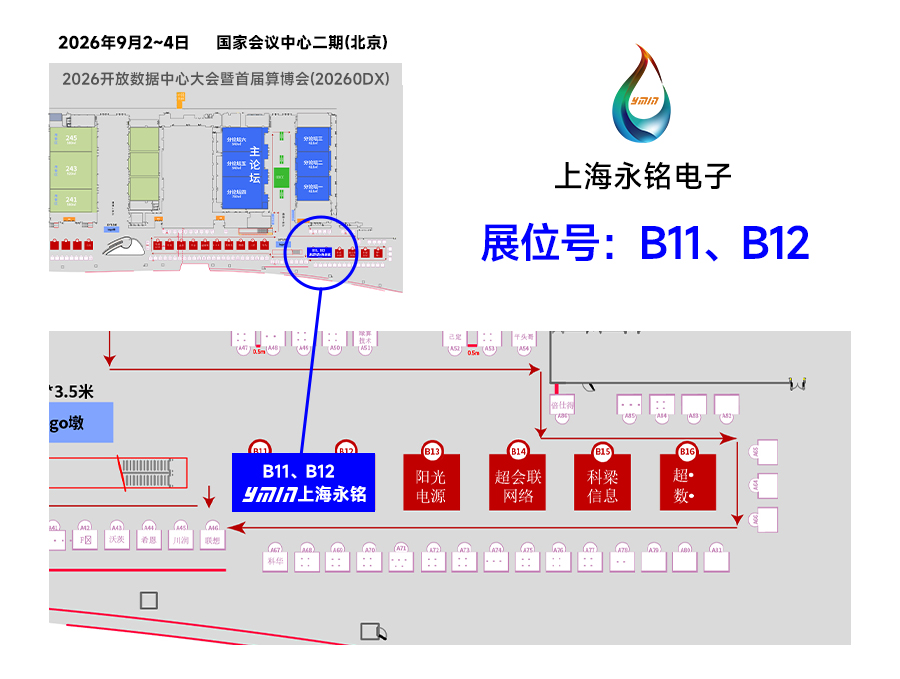
  2026年9月2-4日,2026开放数据中心大会(ODX)暨首届算博会将在北京国家会议中心二期盛大启幕。上海永铭电子股份有限公司将在B11超级电容展区、B12电解电容展区重磅亮相。  本次展会,永铭电解电容展区将围绕AI服务器主供电源、SSD存储、主板算力三大核心应用场景,展示液态牛角型、液态插件型、高分子混合动力、高分子聚合物钽、叠层高分子固态电解电容等多品类产品矩阵。本文聚焦主板算力场景,详解永铭电容方案如何为AI服务器CPU/GPU供电提供纳秒级瞬态支撑。  主板场景:两大产品线协同,筑牢算力供电根基  AI服务器CPU/GPU瞬时功耗剧烈波动,供电末端电容需要以极低ESR快速响应纳秒级电流变化,防止电压下陷导致降频或重启;同时需在MHz频段提供低阻抗路径,抑制高频纹波对高速信号的干扰。  永铭针对主板算力场景,已形成高分子聚合物钽电容与叠层高分子固态铝电解电容(MLPC) 两大产品线,紧贴CPU/GPU部署,为AI芯片供电提供最后一道保障。  展品亮点速览  高分子聚合物钽电容 —— 高容值密度,高频去耦优选  永铭TQD系列聚合物钽电容,采用新一代底面端子结构,兼具高容值密度与快速频率响应特性,适用于CPU/GPU周边高频电路中的储能与滤波。  核心优势:  l 高容值密度:底面端子结构同尺寸下钽芯体积提升25%,在有限PCB面积内存储更多电荷  l 快速频率响应:适用于高频电路中的储能和滤波,减少高频噪声对电路的影响  l 薄型化优势:1.5mm/1.9mm超薄封装,适配高密度主板布局  l 低ESR:在CPU/GPU周边供电场景下提供高效稳定的瞬态响应  叠层高分子固态铝电解电容(MLPC)—— 超低ESR,纳秒级瞬态支撑  永铭MPS/MPD19/MPD28系列叠层高分子固态铝电解电容,以叠层结构实现小体积、大容值、低ESR、低漏流、高可靠,专为AI服务器CPU/GPU周边供电设计,为高密度算力板卡提供高效稳定的瞬态响应。  核心优势:  超低ESR:MPS系列ESR低至9mΩ,有效降低电源转换能量损失  小体积大容值:7.3×4.3mm超薄封装(薄至1.0mm),紧贴CPU/GPU部署,不挤占宝贵PCB空间  低漏电流:新型底部电极结构无需折弯,避免对芯包二次破坏,漏电流无变化  高可靠:满足105℃/2,000H寿命等级,适配高可靠性应用场景  两场主题演讲 · 深度技术分享  除展品展示外,永铭电子还将在本次算博会的两场核心分论坛中发表主题演讲:  9月2日 | 会场5 · 服务器分论坛  永铭超级电容在服务器主(备用)电源中的解决方案  9月4日 | 会场5 · 存储部件分论坛  永铭电容在SSD中的应用  相约北京,共赴算力盛宴  2026算博会以"开放算力生态,Token普惠创新"为主题,超8,000㎡展区将汇聚算力芯片、液冷技术、智算集群等全链条产品与方案。  永铭主板算力全场景电容方案均已就位。无论您正在设计下一代AI服务器CPU/GPU供电架构,还是为高密度主板寻找低ESR电容方案——欢迎整机厂商、服务器方案设计商、数据中心架构师莅临B12电解电容展区,现场获取规格书、选型建议与FAE技术对接支持。  联系我们:  官网:www.ymin.com  微信公众号:上海永铭电容器  产品热线:400-900-1922  我们期待与您面对面交流电容器在AI算力领域的最新技术突破,共同推动中国算力产业从"能用"迈向"好用、易用、优用"!
关键词:
发布时间:2026-08-27 13:03 阅读量:447 继续阅读>>
海康存储亮相FMW2026全球闪存峰会 斩获AI<span style='color:red'>算力</span>性能标杆大奖
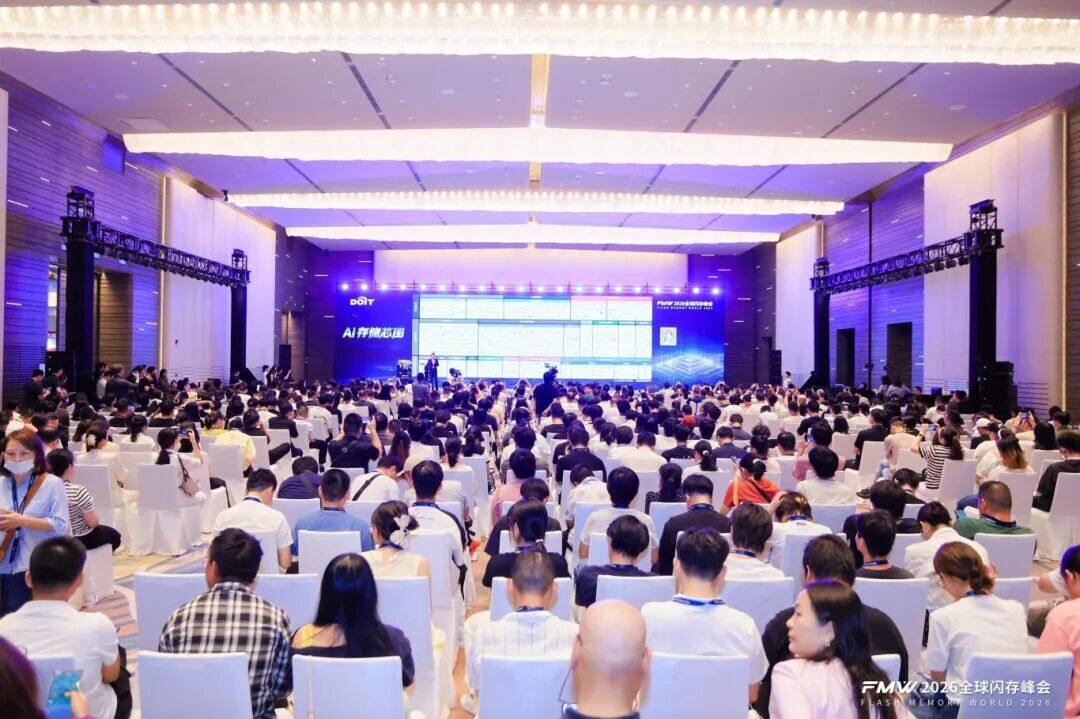
  8月26日,以“存力跃迁,AI破局”为主题的2026全球闪存峰会(FMW)在武汉隆重启幕。本届峰会聚焦存储产业前沿发展趋势,围绕存算一体化技术迭代、闪存介质创新突破、AI原生存储系统构建等核心热点展开深度研讨,汇聚了存储产业链上下游头部企业,搭建高端化、专业化的产业交流与技术共创平台。  本次盛会集结了得瑞领新、华为、紫光闪芯、长江存储等存储上游核心厂商,以及联想、NetApp、浪潮信息等下游服务器与存储系统龙头企业,全方位展现全球闪存与AI存储产业的前沿技术成果、产品方案与未来发展趋势。  海康存储作为参展商之一,与产业链上下游合作伙伴深入交流,共同探讨AI技术高速迭代下,存储产业的变革机遇、技术革新与生态共建路径。  01  重磅产品斩获“AI算力基石性能标杆奖”  彰显AI算力存储硬实力  峰会现场,海康存储携数据中心级、工业控制级全场景存储产品矩阵协同亮相,搭建起分层、全覆盖的存储产品体系,精准匹配AI算力、云计算、工业数字化等多领域核心需求,全方位展现品牌的技术沉淀与完善的产品布局。  其中,R1 DDR5 RDIMM服务器内存模组凭借出色的场景适配能力与稳定的运行表现,成功斩获“2026年度AI算力基石性能标杆奖”,充分印证了海康存储在AI服务器内存领域的前沿技术水平与产品实力。  02  三层立体化产品矩阵  全覆盖赋能算力与与工业场景  海康存储本次展出产品构建了三层产品矩阵,纵向覆盖高性能内存、企业级固态存储、工业级嵌入式存储,层层赋能不同场景核心算力与存储需求,实现数据中心、工业控制全场景精准落地。  算力内存层以R1 DDR5 RDIMM服务器内存模组为核心,精准聚焦AI模组训练、智能推理等密集型工作负载,直击算力场景中内存访问延迟敏感的核心痛点。  产品搭载寄存器信号优化技术与8位奇偶校验信号纠错机制,有效保障高并发、高速运算场景下的数据传输精准度与系统运行稳定性;同时R1提供16/32/64GB多规格容量选择,频率覆盖4800/5600/6400MHz,可灵活适配不同算力规模的服务器配置需求,为AI训练、推理等密集型工作负载提供坚实的内存底层支撑。  数据中心层由D300系列钽电容SATA III固态硬盘坐镇,主要适配数据中心操作系统启动、温数据存储等核心场景。  产品搭载专属钽电容断电保护技术,搭配稳定均衡的读写性能,能够有效规避断电故障带来的数据丢失、文件损坏等问题,可靠性大幅提升。同时产品兼容传统存储架构,为行业用户提供从传统HDD机械硬盘向SSD固态硬盘平滑迁移的高效解决方案,助力数据中心存储架构低成本、高效率升级。  工业边缘存储层依托V310系列SATA III SSD、PTS13 PCIe Gen4×4 SSD与PTS11 PCIe Gen3×4 SSD多款核心产品全面覆盖,全方位适配工业控制、嵌入式设备、高性能边缘计算等多元场景。  产品针对性优化硬件性能,可满足宽温运行、高耐久、小型化、高抗震等严苛工业环境需求,适配从常规工业自动化应用到高端边缘算力部署的全层级场景,夯实工业数字化、边缘智能化的存储底座。  海康存储三层产品矩阵形成了从极致性能内存到大容量固态存储、从云端算力中心到工业边缘终端的全维度覆盖,精准匹配AI大模型训练推理、云计算及工业数字化等场景的多元存储需求,充分展现了品牌全场景、高适配、高可靠的存储产品核心优势。  本次R1 DDR5 RDIMM斩获行业大奖,更是市场与行业对海康存储研发实力、产品品质与场景创新能力的高度肯定。  立足AI高速发展的产业浪潮,未来,海康存储将持续深耕存储核心技术研发,以创新产品与解决方案赋能AI时代的数据基础设施建设,助力千行百业的数字化转型与智能化升级。
关键词:
发布时间:2026-08-27 10:44 阅读量:436 继续阅读>>
昆仑芯联合蚂蚁密算打造国产GPU机密计算方案,夯实国产AI安全<span style='color:red'>算力</span>底座
近日,中国信息通信研究院泰尔终端实验室(以下简称“泰尔终端实验室”)正式发布国内首份面向通用 GPU TEE(可信执行环境)的专项系统检测报告。本次测评是国内首次针对通用GPU可信执行环境技术开展权威专业评测,围绕安全隔离、远程证明、密态大模型推理安全保护三大核心维度完成严苛验证。作为首批完成适配的国产AI算力平台之一,昆仑芯P800系列产品已全面兼容该GPU TEE方案,双方共同打造兼具高性能、高安全的国产AI可信计算解决方案,为企业级大模型部署提供更加安全可靠的算力底座。依托昆仑芯P800系列产品与蚂蚁密算通用GPU TEE HyperGPU技术,该方案无需更换现有硬件,即可为昆仑芯GPU平台赋予可信执行能力,实现模型权重、用户提示词、推理结果等敏感数据在GPU计算过程中的硬件级安全保护,覆盖安全隔离、远程证明、密态推理等关键能力,有效解决AI训练与推理过程中“数据在用即裸奔”的行业难题,为国产AI算力筑牢硬件级数据安全底座。该方案通过在昆仑芯P800系列产品的AI服务器部署由蚂蚁密算团队提供的整套GPU TEE,即可为昆仑芯GPU平台赋予可信执行能力,整个P800的软件栈可以完整运行在蚂蚁密算团队提供的GPU TEE中实现正常业务操作。根据泰尔系统实验室测试结果,在开启全链路密态保护及最高级别安全防护的情况下,该方案推理性能损耗低于2%,实现安全能力与计算性能兼顾。基于昆仑芯领先的AI算力性能和完备的软件生态,结合蚂蚁密算机密计算技术,双方为数据敏感行业提供兼具高性能、高安全、自主可控的大模型基础设施解决方案。作为业界领先的AI计算芯片及软硬件系统供应商,昆仑芯科技始终坚持开放生态发展理念,持续完善芯片、集群系统和软件平台能力,已完成对国内主流模型的快速适配,并不断携手产业伙伴推动国产AI基础设施能力升级。此次与蚂蚁密算联合推进GPU可信执行环境落地,是昆仑芯在完善AI基础设施安全能力方面的重要实践,也进一步拓展了国产AI算力平台在机密计算领域的应用边界。未来,双方将围绕大模型训练、推理及多方协同计算等场景持续深化合作,加快国产算力可信执行环境在更多行业和应用场景中的落地,推动国产AI基础设施实现计算性能、安全可信与自主可控能力的协同提升,为大模型规模化应用提供更加坚实的安全算力底座。
关键词:
发布时间:2026-08-26 13:28 阅读量:537 继续阅读>>
筑牢边缘<span style='color:red'>算力</span>基座,加速物理AI落地:恩智浦完整机器人技术生态
  在日前举办的2026第七届国际AI-IoT生态发展大会上,恩智浦从前瞻性的芯片产品到一站式的解决方案,全面展示了公司快速响应市场需求,着力打造的完整机器人技术生态。  在活动中,恩智浦的i.MX RT1180跨界MCU荣获了“年度创新技术产品奖”,充分显示了恩智浦在筑牢边缘算力基座方面的技术实力。  i.MX RT1180跨界MCU,采用800MHz的Arm Cortex-M7和300MHz的Arm Cortex-M33双核架构,内置1.5MB片上SRAM,能够实现高性能和实时控制功能,同时集成了千兆时间敏感网络 (TSN) 交换机和EtherCAT SubDevice控制器,天然契合机器人对高实时性、多节点协同与确定性通信的需求。  i.MX RT1180的Cortex-M7与Cortex-M33内核可提供充足算力,支撑感知、控制与边缘决策融合,助力构建高响应、高可靠的智能机器人系统;同时,EdgeLock安全功能与丰富的工业协议支持有助于实现安全互联,配合完善开发生态,能够大大加速机器人方案从原型到量产的落地。  值得一提的是,i.MX RT1180并非一枝独秀,而是恩智浦丰富的嵌入式边缘算力产品组合中的一员。面对AI从云端走向边缘、嵌入式系统从“控制为核心”向“感知+决策融合”转变的大趋势,恩智浦缜密布局,目前已经构建起包括MCU、MPU和DNPU多种算力平台在内的完整产品矩阵。  在题为《边缘智能时代的嵌入式演进:从MCU、MPU到DNPU看AI驱动的技术趋势》演讲中,恩智浦大中华区高级商务拓展经理陈黎对这些算力器件在未来边缘计算架构中的角色演进进行了分析,重点介绍了恩智浦在Edge AI领域的技术布局,并通过MCU、i.MX RT与i.MX MPU,以及DNPU平台的对比,探讨如何在性能与功耗之间取得平衡,让AI能力成为新一代嵌入式系统的关键竞争力。  在以丰富的产品组合筑牢边缘算力基座基础上,恩智浦还针对机器人市场痛点,提供整体的解决方案,包括关节、灵巧手、大脑,小脑等关键部件,覆盖从域控、感知模块到功能安全等核心场景。  在本届大会的AI机器人论坛上,恩智浦大中华区高级商务拓展经理陈黎在题为《恩智浦机器人解决方案构建可靠未来》的演讲中,对此进行了全面地梳理。  演讲中重点提及的方案包括:  控制总线:恩智浦的i.MX RT1180创新性地集成了支持TSN的千兆交换机与EtherCAT从站IP,配合SPE(单对以太网)技术,仅需两根线即可完成通信。  灵巧手:恩智浦提供了基于I3C总线的分布式架构、多路UART分布式架构及集中式架构三种选择,以适应不同自由度与实时性要求。  机器人“大脑”:恩智浦可提供从MCU、网络交换机到高性能MPU的全栈方案。i.MX 95与Kinara Ara240独立NPU的组合方案,支持运行LLaVA等多模态大模型,赋予机器人强大的环境理解与生成式AI交互能力。  功能与信息安全:从MCU硬件完整性到EdgeLock安全元件,为机器人走向工业与家庭构筑坚实的“安全底座”。  除了技术演讲,恩智浦还在本届AI-IoT生态发展大会的现场,展示了恩智浦三大机器人应用演示方案,让与会观众能够直观地体验到如何利用恩智浦日益完善的技术生态,加速物理AI在机器人这个风口应用中落地!  基于I3C总线拓扑的人形机器人灵巧手方案  基于LeRobot (VLA) 和FRDM-i.MX 95的机械臂控制  基于MCX-A34X的电感式编码器方案
关键词:
发布时间:2026-07-28 10:13 阅读量:594 继续阅读>>

跳转至

/ 6

  • 一周热料
  • 紧缺物料秒杀
型号 品牌 询价
CDZVT2R20B ROHM Semiconductor
BD71847AMWV-E2 ROHM Semiconductor
MC33074DR2G onsemi
TL431ACLPR Texas Instruments
RB751G-40T2R ROHM Semiconductor
型号 品牌 抢购
BU33JA2MNVX-CTL ROHM Semiconductor
BP3621 ROHM Semiconductor
IPZ40N04S5L4R8ATMA1 Infineon Technologies
ESR03EZPJ151 ROHM Semiconductor
TPS63050YFFR Texas Instruments
STM32F429IGT6 STMicroelectronics
热门标签
ROHM
Aavid
Averlogic
开发板
SUSUMU
NXP
PCB
传感器
半导体
关于我们
AMEYA360商城(www.ameya360.com)上线于2011年,现有超过3500家优质供应商,收录600万种产品型号数据,100多万种元器件库存可供选购,产品覆盖MCU+存储器+电源芯 片+IGBT+MOS管+运放+射频蓝牙+传感器+电阻电容电感+连接器等多个领域,平台主营业务涵盖电子元器件现货销售、BOM配单及提供产品配套资料等,为广大客户提供一站式购销服务。

请输入下方图片中的验证码:

验证码